Explorée, actuellement non indexée sur un petit site
Retrouvez Trust SEO dans vos recherches Google Ajoutez le site à vos sources préférées : Google aura tendance à mettre ses articles en avant pour vous.
Sommaire
Votre nouvelle page de services est en ligne depuis plusieurs semaines. Search Console indique que Googlebot l’a lue, avec une date de passage précise. Elle ne sort pourtant sur aucune recherche, pas même sur son propre titre, et l’outil se contente d’un statut en deux temps qui ressemble à une hésitation du moteur.
Ce statut ne concerne qu’une partie des cas où une page manque à l’appel. Si vous ne savez pas encore de quel côté se situe le problème, le test qui sépare les deux pannes possibles vous fera gagner du temps avant d’aller plus loin.
Ici, la page a été lue, et Google a décidé de ne pas la ranger dans son index pour le moment. Ce guide part d’un site de PME, quelques dizaines de pages, où chaque page compte et où les causes ne sont pas celles d’un site marchand de dix mille références.
Ce que Google écrit de ce statut
Le rapport sur l’indexation des pages le définit en une phrase : « La page a été explorée par Google, mais pas indexée. Elle sera peut-être indexée à l’avenir ; il n’est pas nécessaire de renvoyer cette URL pour l’exploration. »
Le même rapport affiche un statut voisin qu’il ne faut pas confondre. « Détectée, actuellement non indexée » signifie que Google connaît l’adresse sans l’avoir encore lue : « l’exploration a été reportée ». La page n’a alors pas été jugée, elle attend son tour.
D’autres statuts parlent de doublons, comme « Page en double sans URL canonique sélectionnée par l’utilisateur » ou « Autre page avec balise canonique correcte ». Ceux-là indiquent que Google a gardé une autre version de la page, ce qui relève d’un autre diagnostic. Quand une alerte relève de la technique plutôt que du jugement, le tri des erreurs techniques qui bloquent l’indexation est le bon point de départ.
Le statut explorée et non indexée n’est pas une erreur : aucun réglage ne le corrige d’un geste. Il peut toucher un site bien entretenu, sur une page soignée. Il dit seulement qu’au moment de son dernier passage, Google n’a pas trouvé de raison suffisante de garder la page.
Première vérification : Google a-t-il vu votre dernière version ?
Avant de réécrire quoi que ce soit, ouvrez l’inspection d’URL de Search Console et notez la date de « Dernière exploration ». L’aide de Google précise que « toutes les informations affichées dans cet outil proviennent de la dernière version explorée ».
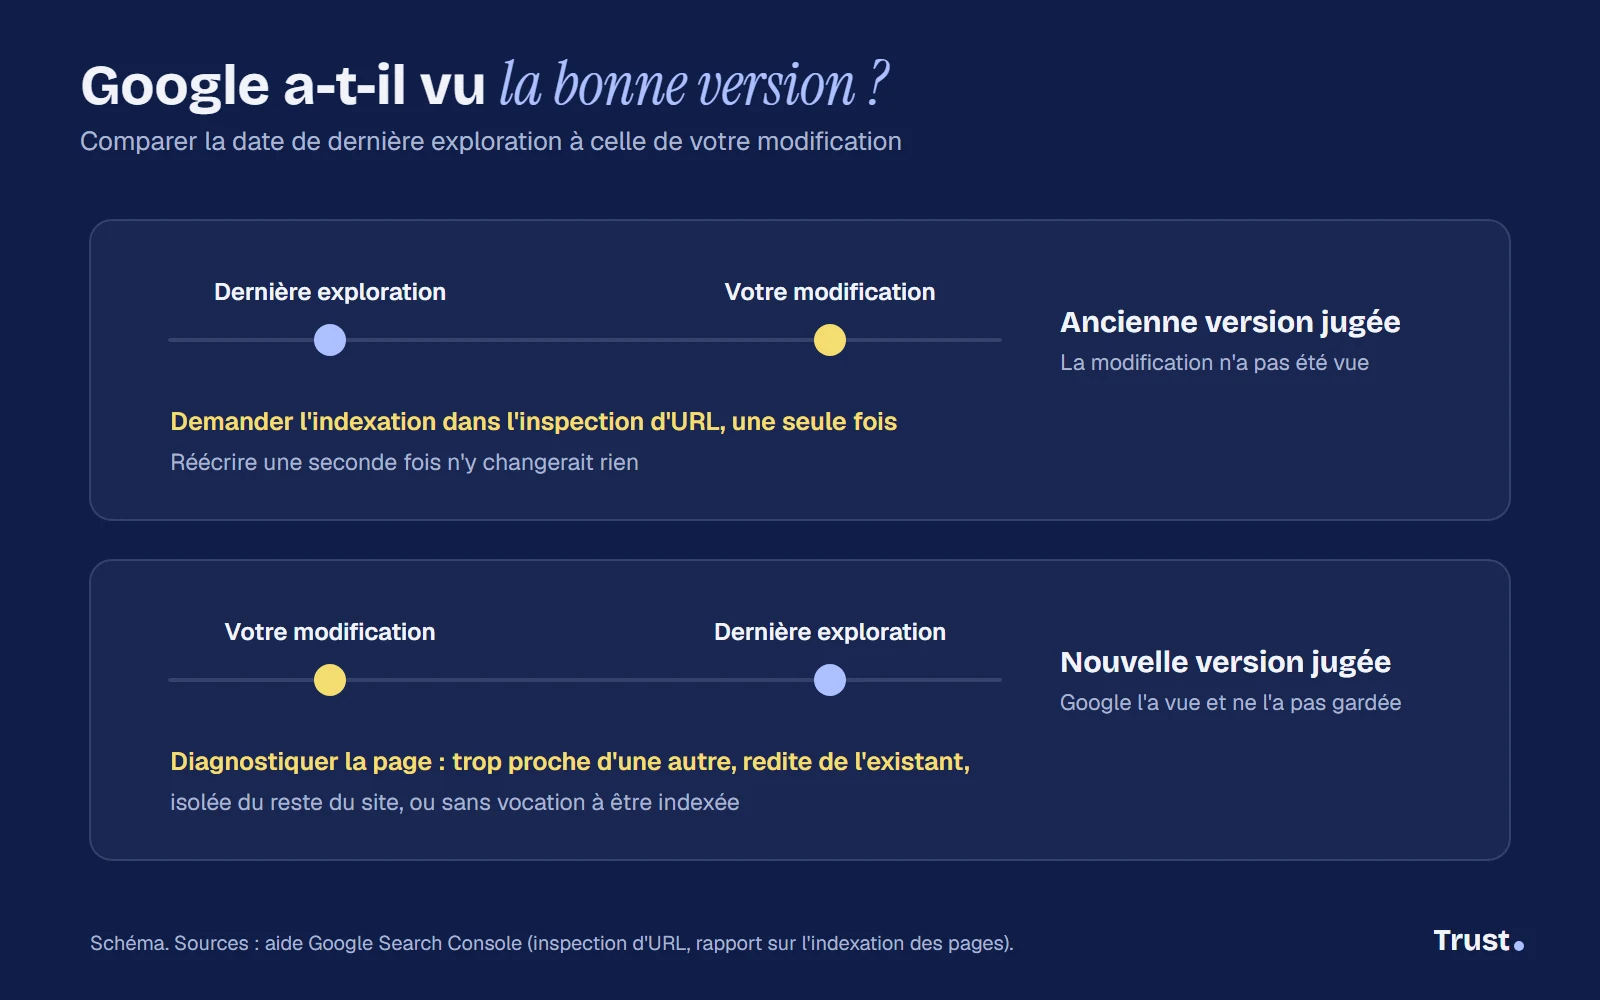
Comparez cette date avec celle de votre dernière modification. Si l’exploration est antérieure, Google juge encore l’ancienne version de la page : votre amélioration n’a jamais été évaluée, et une seconde réécriture n’y changera rien. Le sitemap mis à jour ne suffit pas toujours à faire revenir le robot rapidement.
Dans ce cas, cliquez sur « Tester l’URL en direct », vérifiez que la page s’affiche correctement, puis sur « Demander l’indexation », une seule fois. La documentation sur les demandes d’exploration prévient que l’exploration « peut prendre plusieurs jours, voire plusieurs semaines », et que les demandes répétées pour une même adresse n’accélèrent rien.
Si la date d’exploration est postérieure à votre modification, Google a vu la bonne version et ne l’a pas retenue. Le diagnostic porte alors sur la page elle-même et sur sa place dans le site.
Ce qui fait basculer une page sur un petit site
Des pages trop proches les unes des autres
Un site de PME peut décliner son offre en plusieurs pages qui se ressemblent : une page par service, une page par ville, une page par type de client. Quand elles partagent la même structure et les mêmes phrases, Google n’a aucune raison d’en garder plusieurs. Il en retient une et laisse les autres de côté.
Le remède consiste à donner à chaque page ce qu’aucune autre ne dit : un cas, une contrainte propre, une question que seule cette page traite. Si deux pages n’ont rien de distinct à dire, les fusionner et rediriger l’une vers l’autre par une redirection permanente vaut mieux que les maintenir toutes les deux. Les redirections d’une refonte obéissent aux mêmes règles.
Une page qui répète ce qui existe déjà ailleurs
La page la mieux écrite peut rester hors de l’index si elle ne dit rien de plus que les résultats déjà en place. Le guide de Google sur le contenu utile pose la question sans détour : « Si votre contenu s’appuie sur d’autres sources, l’avez-vous simplement recopié ou reformulé, ou y avez-vous apporté de la valeur ajoutée et une touche d’originalité ? »
Pour le vérifier, tapez la recherche que votre page vise et lisez les premiers résultats. Si votre page reprend les mêmes points dans le même ordre, elle n’a pas encore de raison d’exister aux yeux du moteur. L’ajouter par des mots ne règle rien : le guide de démarrage de Google rappelle que la longueur du contenu n’a pas d’importance pour le classement. Le même défaut explique pourquoi un contenu bien écrit n’est jamais repris par les IA.
Une page que rien ne relie au reste du site
Le guide de démarrage de Google le dit simplement : « Google trouve essentiellement des pages à l’aide de liens provenant d’autres pages déjà explorées. » Une page publiée sans aucun lien depuis l’accueil, les pages de services ou les articles reste un îlot. Google peut la trouver par le sitemap, mais rien sur le site ne lui indique qu’elle compte.
Les liens venus d’autres sites jouent aussi, et les outils les résument en scores dont la lecture appelle de la prudence. Sur un petit site, les liens internes restent le levier le plus direct.
Ajoutez des liens vers elle depuis les pages qui en parlent déjà, dans le texte, avec des formulations qui décrivent ce qu’on y trouve. Sur un site de quelques dizaines de pages, c’est aussi l’action la plus simple.
Des adresses qui n’ont pas vocation à être indexées
Une partie des adresses de ce statut n’a rien à faire dans l’index : pages d’étiquettes, archives par date, pages 2 et 3 d’une liste, adresses avec paramètres de tri. Les CMS en créent automatiquement, et les réglages propres à WordPress, Webflow ou Framer décident de leur nombre. Leur présence dans le rapport n’est pas un problème. Les laisser là, ou les passer en noindex, est une décision raisonnable.
Trier vos adresses sans outil payant
Dans le rapport Pages de Search Console, ouvrez le statut et exportez la liste avec le bouton d’export. Google précise que la liste d’exemples est limitée à 1 000 entrées, ce qui couvre largement un site de PME.
Classez ensuite les adresses par motif plutôt qu’une par une : les pages de services et d’offres, les articles, les pages de villes ou de secteurs, puis tout ce que le CMS a généré tout seul. Ce classement suffit à faire apparaître le problème. Des étiquettes et des archives non indexées ne coûtent rien ; une page de services non indexée coûte des demandes de contact.
Pour chaque page qui compte, une décision : l’améliorer si elle a quelque chose de propre à dire, la fusionner avec sa voisine si elle n’en a pas, ou la retirer de l’index si elle n’a pas vocation à sortir. Une fois la page indexée, la lecture de ses impressions et de ses clics dans Search Console dira si elle trouve sa place dans les résultats.
Ce qui ne sert à rien
Redemander l’indexation tous les jours ne fait pas revenir Google plus vite, et sa documentation le dit en toutes lettres. Ajouter cinq cents mots à une page pour franchir un seuil supposé ne change pas son statut, puisque la longueur n’est pas un critère. Supprimer en masse des pages non indexées sans redirection fait perdre les liens qui pointaient vers elles.
Le statut reflète un jugement sur la page et sur le site. Il se corrige en donnant à chaque page une raison d’exister, ce qui est l’objet d’un audit qui part des pages qui comptent pour votre activité. Pour un suivi dans la durée, page par page, l’accompagnement mensuel prend le relais.
FAQ
Que signifie « Explorée, actuellement non indexée » dans Search Console ?
D’après l’aide de Google, la page a été explorée mais pas indexée. Elle sera peut-être indexée à l’avenir, et il n’est pas nécessaire de renvoyer l’adresse pour l’exploration. Google a donc lu la page et choisi de ne pas la garder pour l’instant.
Quelle différence avec « Détectée, actuellement non indexée » ?
Une page détectée est connue de Google mais n’a pas encore été explorée : l’exploration a été reportée. Une page explorée a été lue, puis laissée hors de l’index. Les deux statuts ne se traitent pas de la même façon.
Faut-il redemander l’indexation chaque jour ?
Non, ça ne sert à rien. La documentation de Google précise qu’un quota limite ces demandes et que les demandes répétées pour une même URL n’accélèrent pas l’exploration. Demandez l’indexation une fois, après une vraie modification de la page.
Combien de temps après une correction la page peut-elle être indexée ?
Google ne garantit aucun délai. Sa documentation indique que l’exploration peut prendre plusieurs jours, voire plusieurs semaines, et qu’une demande d’exploration ne garantit pas l’inclusion dans les résultats. Suivez l’évolution dans l’inspection d’URL.
Retrouvez Trust SEO dans vos recherches Google Ajoutez le site à vos sources préférées : Google aura tendance à mettre ses articles en avant pour vous.
Et si on identifiait ce qui bloque votre site ?
Analyse technique, sémantique et netlinking avec un plan d'action priorisé sur 6 à 12 mois.
Découvrir l'audit SEO