Erreurs techniques SEO : celles qui bloquent vraiment
Retrouvez Trust SEO dans vos recherches Google Ajoutez le site à vos sources préférées : Google aura tendance à mettre ses articles en avant pour vous.
Sommaire
Le rapport arrive en PDF, avec une note sur cent en couverture et des dizaines de lignes classées en rouge, orange et jaune. Pages trop lentes au regard des Core Web Vitals, balises canoniques en double, liens cassés, images sans texte alternatif, codes 404 ou 5xx : chaque ligne porte le même ton d’urgence. Vous ne savez pas laquelle vous coûte des clients, et la note ne vous le dira pas.
Un outil d’audit compare votre site à une liste de contrôle. Il ne sait pas quelles pages comptent pour votre activité, ni ce que Google fait de chaque écart qu’il relève. Avant de vous lancer dans ce tri, vérifiez d’abord si votre site souffre d’un problème d’indexation ou de positionnement : la réponse change l’ordre de tout le reste.
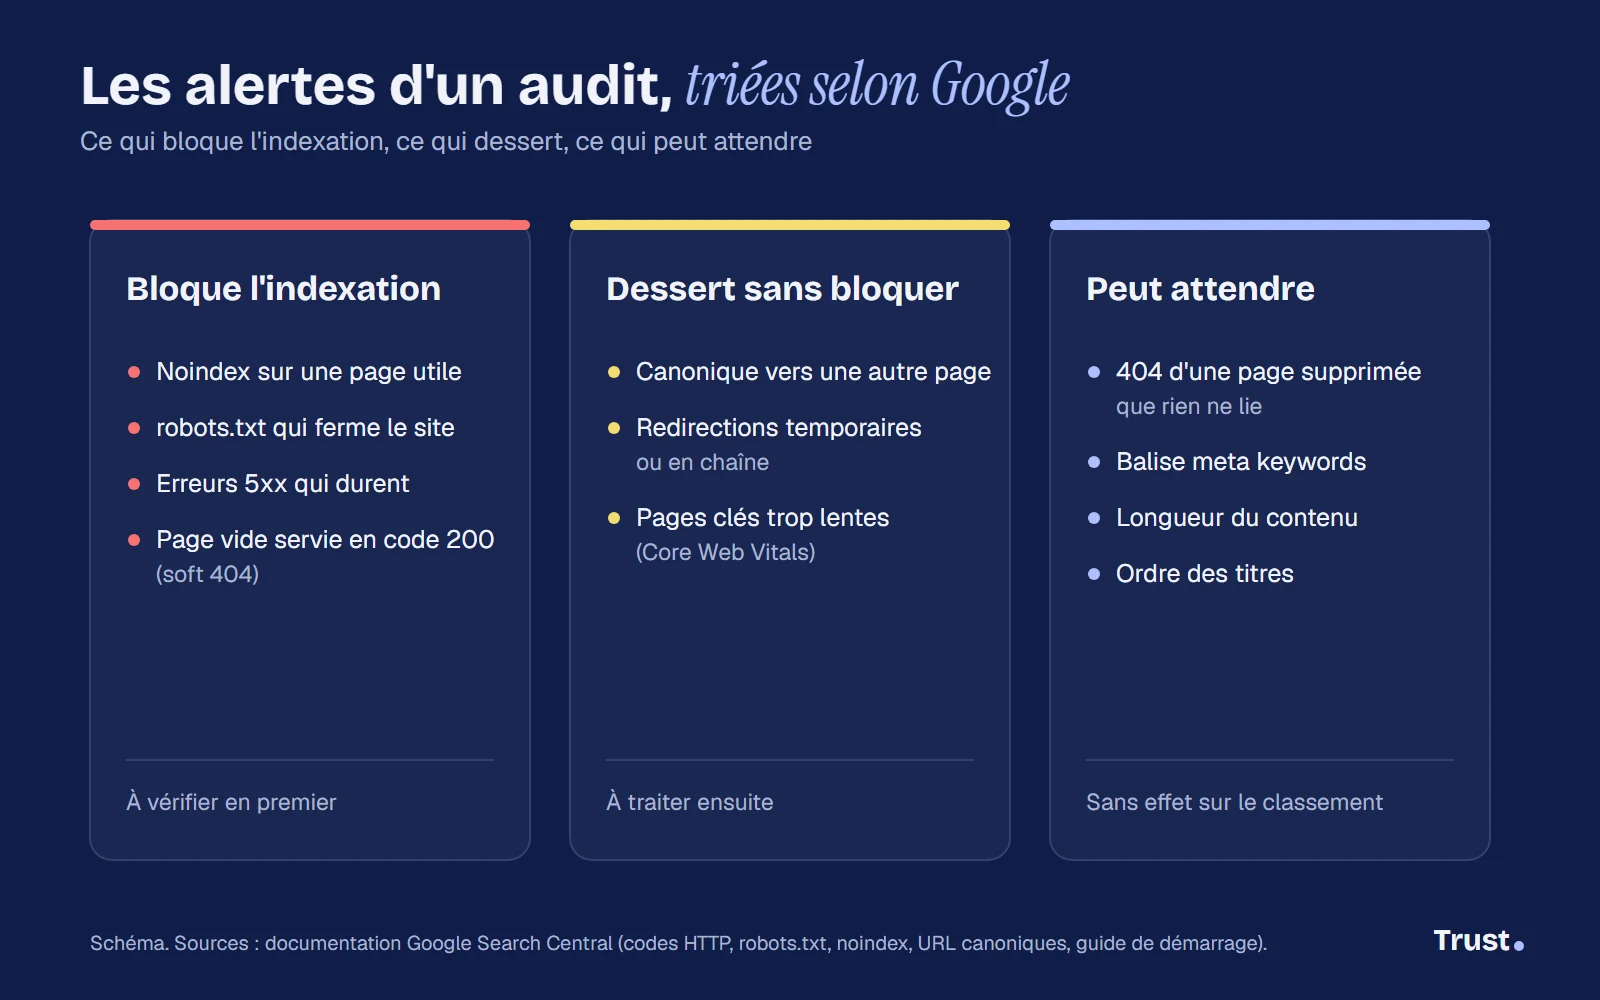
Google publie pourtant, page après page, ce qu’il fait de nombreuses alertes de ce type. Ce guide les range selon sa propre documentation : celles qui empêchent une page d’entrer dans l’index, celles qui la desservent sans la bloquer, et celles qui peuvent attendre.
Ce que l’outil compte, et ce qu’il ne voit pas
Un robot d’audit parcourt votre site comme Googlebot le ferait, puis applique ses propres règles : une balise title au-delà d’une certaine longueur, une page sous un certain nombre de mots, une image sans attribut alt. Chaque règle produit une alerte, et chaque alerte pèse le même poids dans la note finale.
Deux informations lui manquent, que seule Google Search Console approche. La première est la valeur de vos pages : une erreur sur une page d’archive que personne ne visite n’a rien à voir avec la même erreur sur votre page de services. La seconde est le traitement que Google applique à chaque écart, qui contredit parfois la règle de l’outil. La documentation de Google sur les erreurs techniques SEO reste la seule référence qui tranche, et c’est elle qui sert de grille ici.
Certains rapports ajoutent un score d’autorité maison, calculé par l’outil à partir des liens qu’il a lui-même trouvés, et ce que mesurent vraiment ces scores de liens mérite d’être lu avant d’en tirer une conclusion.
Gardez une règle simple en lisant la suite : une alerte n’est grave que si elle touche une page qui compte et si elle empêche Google de la lire, de la garder ou de la comprendre.
Les alertes qui empêchent l’indexation
Une balise noindex au mauvais endroit
La balise noindex demande au moteur de ne pas indexer une page. Posée sur une page de remerciement ou un espace client, elle fait son travail. Posée sur votre page d’accueil ou vos pages de services, parfois héritée de la construction du site, elle les retire des résultats. C’est l’alerte à vérifier en premier, page par page, sur celles qui comptent.
Un fichier robots.txt qui ferme la porte
Le fichier robots.txt indique aux robots les adresses qu’ils peuvent explorer. Une ligne Disallow: / interdit l’exploration de tout le site, et Google ne peut alors plus lire le contenu de vos pages. Sa présentation du fichier robots.txt rappelle que ce fichier n’empêche pas une page de figurer dans les résultats : seule la balise noindex l’en retire, à condition que la page reste accessible au robot qui doit la lire.
Des erreurs serveur qui durent
Une erreur 5xx signifie que votre serveur n’a pas su répondre. Une panne de quelques minutes ne pose pas de problème, mais la documentation de Google sur les codes HTTP décrit ce qui arrive quand elle se prolonge : Googlebot ralentit l’exploration, et pour la recherche Google, « les URL déjà indexées sont conservées, mais finissent par être supprimées de l’index ». Un hébergement instable peut donc vider votre présence sans qu’une seule ligne de contenu change.
Une page qui dit « erreur » sans le dire
Une page vide ou un message d’erreur servi avec un code 200, celui d’une page normale, est signalé dans Search Console comme une erreur soft 404. La page existe pour le serveur et ne vaut rien pour le moteur. Le cas se produit avec des fiches produit épuisées, des résultats de recherche interne vides ou des modèles de page mal remplis.
Une page lue mais laissée de côté
Certaines adresses n’ont aucun défaut technique et restent pourtant hors de l’index, parce que Google les a jugées sans les retenir. Aucun réglage ne règle ce cas, et un outil d’audit ne le voit pas : il relève d’un diagnostic de la page elle-même, une fois que Google l’a explorée.
Les alertes qui desservent sans bloquer
Le contenu dupliqué et la balise canonique
Plusieurs adresses qui affichent le même contenu (avec et sans paramètres, en http et en https, avec et sans slash final) obligent Google à choisir une version de référence, l’URL canonique. Sa page sur le regroupement des URL en double classe les signaux qui influencent ce choix : une redirection est un « signal fort », l’annotation rel="canonical" aussi, le sitemap un signal plus faible. Une canonique qui pointe vers la mauvaise page peut écarter celle que vous vouliez voir sortir.
Les redirections mal choisies
Une redirection permanente affiche la nouvelle adresse dans les résultats, une redirection temporaire garde l’ancienne. Pour une page déplacée définitivement, la permanente est la bonne. Les redirections en chaîne ou en boucle ralentissent l’exploration et, au pire, empêchent d’atteindre la page. C’est au moment d’une refonte que ce sujet coûte le plus, et la façon de mener une migration sans perdre ses positions y est consacrée.
La vitesse et les Core Web Vitals
Google l’écrit sans ambiguïté dans sa page sur l’expérience sur la page : « Les Core Web Vitals sont utilisées par nos systèmes de classement ». Il ajoute aussitôt qu’« essayer d’obtenir un score parfait uniquement pour des raisons de SEO n’est pas forcément pertinent », et que pour une requête donnée, le contenu le plus pertinent passe devant même si l’expérience est décevante. Une page de services très lente mérite d’être corrigée. Gagner trois points de score sur une page déjà correcte peut attendre.
Le choix du CMS pèse ici davantage que les réglages fins, et ce que WordPress, Webflow et Framer règlent pour vous diffère sensiblement d’un outil à l’autre.
Les alertes qui peuvent attendre
Les 404 des pages supprimées
Une page supprimée qui renvoie une erreur 404 fait exactement ce qu’on attend d’elle. Le rapport d’indexation de Google le dit clairement : « De manière générale, nous vous conseillons de ne corriger que les erreurs 404 que vous liez à votre site ou listez dans un sitemap. » Une 404 devient un problème quand un lien de votre propre site ou votre sitemap y conduit encore, ou quand la page a été déplacée sans redirection.
Les règles que Google n’applique pas
Plusieurs alertes d’audit reposent sur des critères que Google déclare ignorer. La balise meta keywords, d’après sa liste des balises prises en charge, « n’est pas utilisée par la recherche Google et n’a aucune incidence sur l’indexation ni sur le classement ».
Le nombre de mots aussi. Son guide de démarrage en référencement est explicite : « La longueur du contenu n’a pas d’importance pour le classement ». Une page courte qui répond complètement vaut mieux qu’une page allongée pour atteindre un seuil fixé par un outil.
L’ordre des titres également. Le même guide indique que les titres peuvent être « dans le désordre, peu importe » pour la recherche Google, et que le Web en général n’utilise pas de code HTML valide. Une structure de titres propre aide vos lecteurs, mais une alerte sur un H3 placé avant un H2 ne vous coûte pas de position.
Enfin, les mots-clés dans l’adresse ou le nom de domaine, selon ce guide, « n’ont pratiquement aucun effet hormis leur affichage dans le fil d’Ariane ». Changer des adresses qui fonctionnent pour y glisser un mot-clé crée surtout des redirections.
Lire votre rapport en un quart d’heure
Commencez par la liste des pages qui comptent : l’accueil, les pages de services, les pages qui reçoivent des demandes de contact. Sur un site de PME, la liste reste courte.
Filtrez ensuite le rapport sur ces adresses, et cherchez d’abord ce qui empêche l’indexation : noindex, blocage robots.txt, erreur serveur, soft 404, canonique vers une autre page. Contrôlez chaque cas dans l’inspection d’URL de Search Console, qui montre ce que Google a vu lors de sa dernière exploration.
Ces corrections s’étalent sur plusieurs semaines, et un suivi mensuel des corrections et de leur effet évite qu’elles s’arrêtent au premier tiers.
Traitez ensuite ce qui dessert sans bloquer, en commençant par les pages les plus visitées, et laissez de côté les alertes que Google déclare sans effet. Pour savoir si une correction a eu un résultat, suivez l’évolution des impressions et des clics de la page dans Search Console sur les semaines qui suivent.
Ce qu’un audit doit vous rendre
Un rapport utile ne s’arrête pas à la liste des anomalies : il dit lesquelles touchent vos pages importantes, ce qu’elles coûtent et dans quel ordre les traiter. C’est la différence entre l’export d’un outil et un audit qui classe les actions par impact.
Si un prestataire vous présente un rapport automatique comme un audit, demandez-lui de désigner les trois corrections qui changeront quelque chose pour votre activité, et pourquoi. Les questions qui permettent de juger un consultant avant de signer aident à préparer cet échange.
Le prix d’un audit varie d’ailleurs surtout selon ce travail de tri, et ce qui fait varier le budget d’une prestation SEO se comprend mieux une fois cette différence en tête.
FAQ
Les erreurs 404 nuisent-elles au référencement ?
Pas en elles-mêmes : Google conseille de ne corriger que les erreurs 404 des adresses que vous liez depuis votre site ou que vous listez dans votre sitemap. Une page supprimée volontairement, que plus rien ne lie, peut renvoyer une 404 sans dommage. Si la page a été déplacée, une redirection permanente vers la nouvelle adresse reste la bonne réponse.
Quelle erreur technique peut retirer une page de Google ?
Une balise noindex posée par erreur, et des erreurs serveur qui durent. D’après la documentation de Google, les adresses qui renvoient une erreur 5xx restent un temps dans l’index, puis finissent par en être supprimées. Un fichier robots.txt qui interdit tout le site empêche aussi Google de lire vos pages.
Faut-il viser un score parfait sur les Core Web Vitals ?
Non, d’après Google lui-même. Les Core Web Vitals sont utilisées par ses systèmes de classement, mais sa documentation précise qu’essayer d’obtenir un score parfait uniquement pour des raisons de SEO n’est pas forcément pertinent. Visez des valeurs correctes sur les pages qui comptent pour votre activité.
Un rapport d’audit avec beaucoup d’alertes rouges est-il grave ?
Le nombre d’alertes ne dit rien de la gravité. Un outil compte les écarts à une liste de contrôle sans savoir quelles pages comptent pour vous ni ce que Google fait de chaque écart. Commencez par les alertes qui touchent vos pages importantes et qui empêchent l’indexation, puis traitez le reste par ordre d’impact.
Si vous préférez qu’on fasse ce tri ensemble sur votre site, le pré-audit commence par ces pages-là.
Retrouvez Trust SEO dans vos recherches Google Ajoutez le site à vos sources préférées : Google aura tendance à mettre ses articles en avant pour vous.
Et si on identifiait ce qui bloque votre site ?
Analyse technique, sémantique et netlinking avec un plan d'action priorisé sur 6 à 12 mois.
Découvrir l'audit SEO